
Internet de las cosas (IoT)
Monitoreo IoT y monitoreo de TI: ¿qué cambia en la práctica?
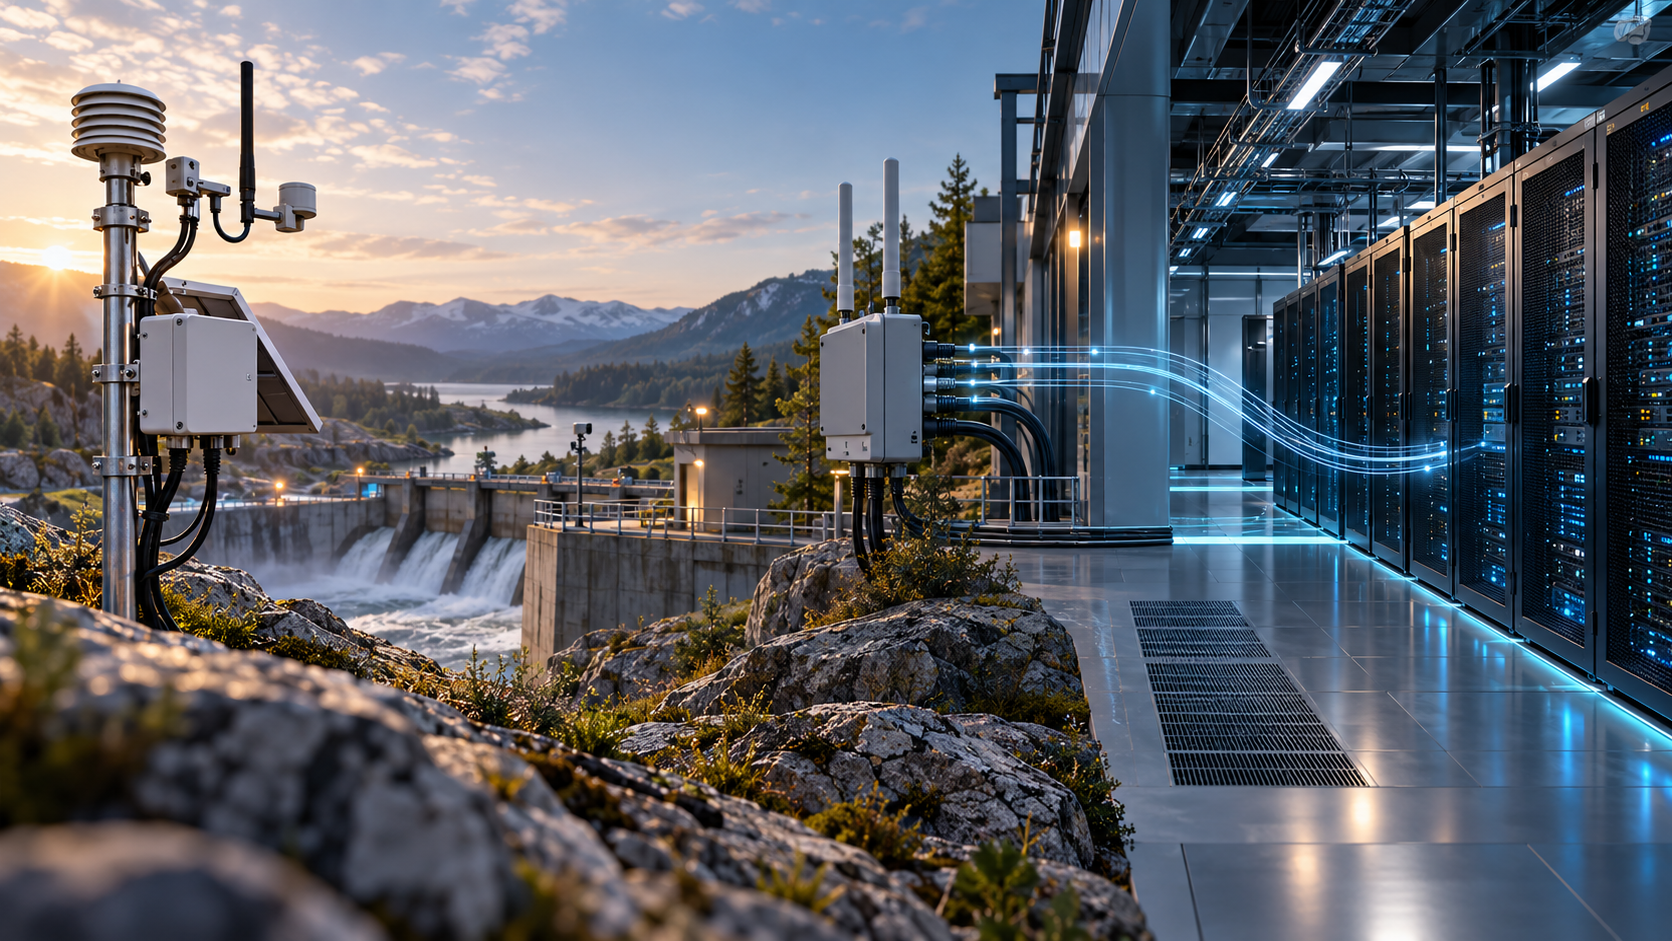
Monitorear un servidor en un centro de datos y seguir un sensor instalado en un equipo industrial son actividades que comparten principios importantes, pero enfrentan condiciones operativas diferentes.
En el primer escenario, el equipo generalmente dispone de una red conocida, sistemas operativos identificables, interfaces de gestión y acceso relativamente controlado al entorno. En el segundo, el activo puede estar a kilómetros de distancia, depender de batería, operar con conectividad intermitente y permanecer expuesto al calor, la humedad, el polvo o la vibración.
Esta diferencia cambia la forma de recolectar información, interpretar indisponibilidades, configurar alertas e investigar fallas.
Esto no significa que las prácticas tradicionales de monitoreo de Tecnología de la Información (TI) dejen de funcionar. Inventario de activos, indicadores de disponibilidad, correlación de eventos, gestión de incidentes y análisis histórico siguen siendo esenciales. Lo que cambia es la manera de aplicar estos principios a dispositivos que no siempre permanecen conectados, responden a consultas o ponen a disposición métricas detalladas.
El monitoreo IoT amplía la visión tradicional de infraestructura para incluir el comportamiento del dispositivo físico, la comunicación y la confiabilidad de los datos producidos en campo.
El punto de partida es diferente
En el monitoreo de TI, los activos más comunes incluyen servidores físicos y virtuales, sistemas operativos, bases de datos, aplicaciones, equipos de red y servicios de infraestructura. El equipo sigue métricas como utilización de procesador, memoria, espacio en disco, latencia, disponibilidad y errores de aplicación.
Muchos de estos componentes se administran centralmente, tienen recursos suficientes para ejecutar agentes o poner a disposición interfaces de gestión y operan en redes diseñadas para ofrecer comunicación continua.
En IoT, el objeto monitoreado también puede ser un pequeño sensor, un medidor inteligente, un rastreador, un controlador industrial o un equipo de comunicación instalado en campo. Estos dispositivos pueden tener poca capacidad de procesamiento y memoria, interfaces de diagnóstico restringidas y diferentes condiciones de alimentación y conectividad.
El National Institute of Standards and Technology (NIST) define un dispositivo IoT por la combinación de al menos un sensor o actuador, que interactúa con el mundo físico, y una interfaz de red, que lo conecta al mundo digital. El instituto también reconoce que el dispositivo puede depender de hubs, servicios en la nube u otros sistemas para ejecutar determinadas funciones [1].
Esta combinación entre componentes físicos y digitales cambia el diagnóstico.
Cuando un servidor presenta una utilización elevada de memoria, el equipo puede consultar métricas del sistema operativo, examinar procesos y relacionar el comportamiento con los logs de la aplicación. Cuando un sensor remoto deja de transmitir, quizá estén disponibles solamente los horarios de los últimos mensajes, el historial de las mediciones y algunos indicadores proporcionados por el gateway.
En ambos casos existe una situación que investigar. La diferencia está en la cantidad de evidencias, en los medios para recolectarlas y en las posibilidades de intervención.
La recolección no siempre comienza en el sistema de monitoreo
Una diferencia importante está en el modelo utilizado para obtener información de los activos.
En muchas arquitecturas de TI, la plataforma consulta periódicamente un objetivo para recolectar métricas. Este modelo se conoce como pull: el sistema central inicia la solicitud y el activo responde. Prometheus, por ejemplo, utiliza normalmente este modelo y señala entre sus ventajas la posibilidad de identificar con mayor claridad cuándo un objetivo deja de responder [2].
En diversas arquitecturas IoT, el flujo comienza en el dispositivo. Este publica una medición o un evento en un gateway, broker o servicio de ingesta, que encamina el mensaje a los sistemas interesados.
MQTT es un protocolo de transporte de mensajes basado en el modelo de publicación y suscripción. Un cliente publica mensajes en tópicos, mientras otros clientes se suscriben a los tópicos relevantes para recibirlos. La especificación también establece que el formato del contenido transportado lo define la aplicación [3].
Esto permite que un sensor envíe información cuando ocurre una medición programada, cuando surge un evento o cuando la conexión está disponible, sin exigir una consulta individual para cada lectura.
Pero la distinción no es absoluta. IoT no significa necesariamente comunicación por envío, así como el monitoreo de TI no funciona exclusivamente por consulta. Algunas soluciones IoT utilizan solicitud y respuesta. El Constrained Application Protocol (CoAP), estandarizado por la Internet Engineering Task Force (IETF), fue diseñado para nodos y redes restringidos y ofrece una capa de interacción basada en solicitudes y respuestas [4].
La diferencia más importante no está en elegir entre pull y push, sino en interpretar correctamente el comportamiento esperado de cada activo.
La disponibilidad puede tener significados diferentes
Un servidor que debería responder continuamente puede considerarse indisponible cuando deja de atender las consultas del monitoreo. Para un dispositivo IoT, un período sin comunicación puede formar parte del funcionamiento normal.
Los sensores alimentados por batería pueden permanecer en modo de bajo consumo durante parte del tiempo. Los medidores pueden transmitir en intervalos predeterminados. Los rastreadores pueden almacenar información localmente cuando pierden conectividad y enviarla después de que la señal regresa.
Considere un medidor que envía una lectura cada 15 minutos. La ausencia de mensajes dentro de esa ventana no representa necesariamente una falla. Si la plataforma genera alertas en intervalos menores que el ciclo normal de transmisión, producirá notificaciones indebidas. Si espera demasiado tiempo, una interrupción real podrá permanecer invisible durante un período incompatible con la aplicación.
Por eso, el monitoreo necesita conocer la frecuencia prevista de los mensajes, la latencia admisible, las posibilidades de retraso, el comportamiento durante fallas de comunicación y el proceso de recuperación cuando la conectividad regresa.
También es necesario diferenciar tres momentos:
El horario en que se realizó la medición.
El horario en que el dispositivo o gateway transmitió el mensaje.
El horario en que la plataforma recibió y procesó la información.
Un gateway puede encaminar datos almacenados durante una interrupción. La entrega es reciente, pero la medición puede ser antigua. Sin esta distinción, un panel puede presentar información atrasada como si describiera la condición actual del activo.
En IoT, recibir un mensaje ahora no significa necesariamente observar lo que está ocurriendo ahora.
El ambiente físico participa del diagnóstico
El monitoreo de TI ya sigue temperatura, energía y condiciones físicas de los centros de datos. Por lo tanto, considerar el ambiente no es exclusivo de IoT.
Lo que cambia es la variedad de los lugares de instalación y la proximidad entre las condiciones ambientales y el funcionamiento del dispositivo.
Un sensor puede estar instalado en una máquina industrial, dentro de un gabinete externo, cerca de motores, en un área rural o en un punto sujeto a humedad, polvo y vibración. La alimentación eléctrica, el montaje, la carcasa de protección y la exposición ambiental pueden afectar tanto al dispositivo como a su comunicación.
Una única falla de energía puede interrumpir un gateway y, como consecuencia, hacer que varios sensores aparentemente desaparezcan. Un gabinete metálico puede interferir en la propagación de la señal. Temperaturas fuera de las especificaciones del fabricante pueden afectar componentes electrónicos o baterías.
Además, la variable medida por el sensor no siempre describe la condición interna del propio dispositivo. La temperatura de un equipo industrial, por ejemplo, no informa necesariamente la temperatura de los componentes electrónicos del sensor instalado sobre él.
El diagnóstico necesita considerar estas relaciones para evitar conclusiones apresuradas e intervenciones en el componente equivocado.
Las evidencias disponibles son más limitadas
Los servidores y las aplicaciones normalmente ofrecen métricas, logs, trazas, acceso remoto y herramientas de diagnóstico. Aun cuando la investigación es compleja, el equipo suele disponer de diferentes fuentes de evidencia.
Los dispositivos IoT más pequeños pueden proporcionar solamente un conjunto reducido de información. En algunos casos, no hay sistema operativo accesible, almacenamiento suficiente para mantener logs ni conectividad constante para una sesión remota.
El diagnóstico pasa a depender de lo que la arquitectura logró preservar fuera del dispositivo: últimos mensajes, calidad de la señal, estado del gateway, indicadores de batería, cambios de configuración e historial de comunicación.
Esta limitación hace que el diseño de la telemetría sea una parte importante del proyecto. Si una información necesaria para investigar fallas no se recolecta durante la operación, quizá sea imposible recuperarla después del incidente.
También cambia la forma de actuación. Reiniciar remotamente un servidor puede ser simple en una infraestructura administrada. Sustituir un sensor en campo puede exigir desplazamiento, acceso físico, repuesto y coordinación con la operación local.
Cuanto menor es la capacidad de diagnóstico remoto, mayor es la importancia de recolectar evidencias útiles antes de que el dispositivo deje de responder.
Protocolos iguales no garantizan datos equivalentes
El ecosistema IoT reúne diferentes protocolos, fabricantes, modelos y formatos. Un equipo puede utilizar MQTT, otro puede comunicarse por CoAP y un tercero puede depender de un protocolo industrial o de un gateway que convierte su información para la plataforma central.
Incluso cuando dos dispositivos usan el mismo protocolo, sus mensajes pueden tener estructuras y significados diferentes. La especificación MQTT define cómo transportar mensajes, pero no establece un modelo universal para el contenido. Unidades, nombres de campos, códigos de estado y convenciones siguen siendo definidos por las aplicaciones [3].
Una arquitectura de monitoreo escalable necesita identificar cada dispositivo y asociarlo a un inventario confiable. También debe normalizar atributos comunes, como fabricante, modelo, ubicación y estado operativo, sin eliminar las características necesarias para comprender cada equipo.
Esta normalización permite construir una visión común, pero no transforma todos los activos en objetos idénticos. Un nivel de batería, una intensidad de señal y un código de falla siguen exigiendo interpretación según el fabricante, el modelo y la función ejercida.
Qué sigue siendo válido de la experiencia de TI
Las particularidades de IoT exigen adaptaciones, pero no justifican descartar prácticas consolidadas de gestión de infraestructura.
El inventario sigue siendo esencial. En IoT, debe incluir información como modelo, firmware, ubicación, conectividad, alimentación, gateway asociado y aplicación que utiliza los datos.
Los indicadores y las líneas de base también siguen siendo necesarios. La diferencia es que los límites deben reflejar el ciclo operativo de cada dispositivo. Un servidor que responde continuamente sigue criterios diferentes a los de un sensor que transmite en períodos específicos.
La correlación de eventos ayuda a evitar que síntomas relacionados se traten de forma aislada. Si diversos sensores conectados al mismo gateway dejan de transmitir al mismo tiempo, se debe investigar la infraestructura compartida antes de presumir fallas independientes en todos los equipos.
Los procesos de gestión de incidentes siguen siendo válidos. Priorización, asignación, escalamiento y cierre siguen siendo necesarios, pero los tickets deben incluir información adecuada al ambiente físico, como la última medición, el horario de recepción, el gateway asociado y la ubicación del activo.
La automatización y el análisis histórico también mantienen su valor. Pueden agrupar ocurrencias, clasificar eventos, encaminar tickets y revelar patrones recurrentes, siempre que respeten las limitaciones de los dispositivos y de las redes.
El principio central es simple: las prácticas tradicionales deben adaptarse, no aplicarse indiscriminadamente.
Una arquitectura integrada necesita observar cuatro capas
En la mayoría de las organizaciones, IoT y TI no forman entornos independientes. Una solución conectada depende de gateways, redes, brokers, servidores, bases de datos, servicios de procesamiento y aplicaciones corporativas.
Por eso, una visión integrada necesita seguir cuatro capas relacionadas.
Infraestructura y servicios centrales
Servidores, máquinas virtuales, redes, bases de datos, brokers, APIs y servicios de ingesta deben seguir bajo el monitoreo tradicional de TI. Una falla en esta capa puede afectar a varios dispositivos, aun cuando todos sigan funcionando en campo.
Dispositivos y comunicación
El seguimiento debe considerar el último mensaje, la frecuencia de transmisión, la calidad de la conexión, el estado energético y las métricas específicas ofrecidas por el equipo.
Calidad y actualidad de los datos
No basta con confirmar que un mensaje llegó. Es necesario verificar si la medición pertenece al intervalo esperado, si permanece coherente y si sigue las reglas definidas para la aplicación.
Correlación y respuesta operativa
Los eventos de las diferentes capas necesitan relacionarse. El objetivo es reconocer dependencias, reducir diagnósticos fragmentados y encaminar cada ocurrencia al equipo responsable con el máximo de contexto disponible.
Esta integración evita que dispositivos, comunicación e infraestructura se traten como universos aislados. También permite diferenciar una falla local de un problema compartido que afecta a toda la cadena.
Ampliar la visibilidad sobre el entorno conectado
El monitoreo IoT y el monitoreo de TI comparten fundamentos, pero lidian con condiciones operativas diferentes.
Los dispositivos instalados en campo pueden transmitir periódicamente, depender de conectividad intermitente, entrar en modo de bajo consumo y ofrecer pocos recursos de diagnóstico. También están sujetos a condiciones físicas que influyen en su funcionamiento y producen datos que deben interpretarse según el contexto de la aplicación.
Estas características no invalidan la experiencia acumulada en infraestructura. Inventario, indicadores, correlación de eventos, gestión de incidentes, automatización y análisis histórico siguen siendo fundamentales.
Para organizaciones que mantienen activos conectados distribuidos, el enfoque más consistente es integrar la visibilidad de la infraestructura central con la condición operativa de los dispositivos en campo. Esto permite investigar fallas considerando las dependencias entre sensores, comunicación, gateways, plataformas y aplicaciones.
Monitorear IoT significa ampliar la capacidad de ver el ambiente físico conectado y relacionarlo con los servicios digitales de los que depende.
Sobre Target Solutions
Target Solutions actúa desde hace más de 15 años apoyando a organizaciones en la evolución de sus operaciones de infraestructura, monitoreo, observabilidad, automatización e inteligencia operativa. A lo largo de esa trayectoria, participó en proyectos en entornos complejos de telecomunicaciones, tecnología, gobierno, energía y grandes empresas, contribuyendo a aumentar la eficiencia operativa y la confiabilidad de los servicios.
Esta experiencia también incluye proyectos relacionados con el Internet de las cosas (IoT), en los que la conectividad, la integración tecnológica y el seguimiento operativo son importantes para transformar dispositivos conectados en soluciones útiles para las organizaciones.
Sobre el autor
Paulo Florêncio de Menezes es cofundador de Target Solutions y actúa desde hace más de 15 años en proyectos relacionados con infraestructura, monitoreo, observabilidad, automatización y operaciones de TI y telecomunicaciones.
Es graduado en Procesamiento de Datos por la Universidad Federal de Amazonas (UFAM), tiene un MBA en Gestión Empresarial por la Fundação Dom Cabral (FDC) y una Maestría Profesional en Economía por la Fundação Getulio Vargas (FGV).
En su investigación de maestría, desarrolló el IBEOP-IA (Índice Brasileño de Exposición Ocupacional Potencial a la Inteligencia Artificial), investigando la exposición potencial de las ocupaciones brasileñas a las capacidades de la IA mediante la combinación de datos ocupacionales, patentes de inteligencia artificial y técnicas de procesamiento de lenguaje natural.
Referencias
[1] NATIONAL INSTITUTE OF STANDARDS AND TECHNOLOGY. Frequently Asked Questions: NIST Cybersecurity for IoT Program.
[2] PROMETHEUS AUTHORS. Frequently asked questions: Why do you pull rather than push? Documentación oficial de Prometheus.
[3] OASIS. MQTT Version 5.0. OASIS Standard, 7 mar. 2019.
[4] SHELBY, Zach; HARTKE, Klaus; BORMANN, Carsten. The Constrained Application Protocol (CoAP). RFC 7252. Internet Engineering Task Force, jun. 2014.